

AMD Instinct™ MI350P PCIe jetzt im MEGWARE Benchmark Center
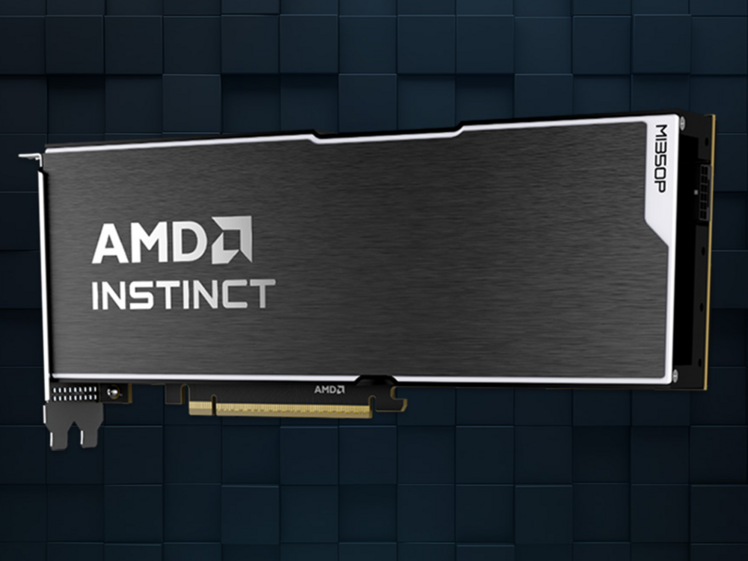
Das MEGWARE Benchmark Center wurde um AMDs neuesten CDNA™ 4-Beschleuniger erweitert: Die AMD Instinct™ MI350P PCIe steht ab sofort für Kundentests zur Verfügung.
144 GB HBM3E im Standard-PCIe-Formfaktor
Mit 144 GB HBM3E-Speicher pro Karte ermöglicht die MI350P den Betrieb von Modellen auf einer einzelnen GPU, für die bislang zwei oder sogar vier Beschleuniger benötigt wurden. Dank ihres Standardformats als PCIe 5.0 Dual-Slot-Steckkarte lässt sie sich problemlos in bestehende Serverplattformen integrieren – ohne OAM-Basisplatine und ohne neues Rack-Design. Dadurch ist sie besonders interessant für Unternehmen, die generative und agentische KI in ihrer vorhandenen Infrastruktur betreiben möchten, anstatt eine komplett neue Umgebung aufzubauen.
Technische Eckdaten
| Architektur | AMD CDNA™ 4 (TSMC 3 nm), 128 Compute Units, 512 Matrix Cores |
| Speicher | 144 GB HBM3E, 4 TB/s Speicherbandbreite, 128 MB LLC, ECC über den gesamten Chip |
| Formfaktor | PCIe 5.0 x16, Dual-Slot, volle Bauhöhe, 267 mm Länge, passive Kühlung |
| Leistungsaufnahme | 600 W TBP, konfigurierbar bis 450 W |
| Maximale Leistung | 4,6 PFLOPS MXFP4/MXFP6, 2,3 PFLOPS FP8/INT8, 1,15 PFLOPS FP16/BF16, 36 TFLOPS FP64 |
| Virtualisierung | SR-IOV, RAS-Unterstützung |
Neu in CDNA 4 ist die native Unterstützung von MXFP4 und MXFP6. Dies stellt gegenüber der MI300X einen deutlichen Fortschritt bei quantisierten Inferenz-Workloads dar und ermöglicht es, sehr große Mixture-of-Experts-(MoE)-Modelle auf einer einzelnen Karte auszuführen.
Welche Modelle lassen sich ausführen?
Als Faustregel gilt: 144 GB HBM bieten Platz für etwa:
- 60 Milliarden Parameter bei BF16
- 120 Milliarden Parameter bei FP8
- 240 Milliarden Parameter bei FP4
Dabei sind KV-Cache und Aktivierungen bereits berücksichtigt.
Beispiele für Modelle, die unter ROCm auf einer einzelnen MI350P betrieben werden können:
- Mistral Small 4
- 119 Milliarden Gesamtparameter, 6,5 Milliarden aktive Parameter
- ca. 119 GB bei FP8
- Der Low-Rank-MLA-Ansatz reduziert den KV-Cache erheblich
- Europäisches Modell
- Qwen3.5 122B-A3B und Nemotron 3 Super 120B-A12B
- ca. 120 GB bei FP8
- ca. 60 GB bei FP4
- Qwen3.8-Flash-Next
- 180 Milliarden Gesamtparameter, 6 Milliarden aktive Parameter
- ca. 93 GB bei FP4
- Kontextlänge bis 262.000 Token
- gpt-oss-120b
- ca. 65 GB in MXFP4
- Apache-2.0-Lizenz
- Native MXFP4-Gewichte nutzen direkt den FP4-Pfad von CDNA 4
- Qwen3-Coder-Next 80B-A3B
- ca. 80 GB bei FP8
- Optimiert für Coding- und Agenten-Workloads
- FLUX.1-dev, SDXL und Whisper large-v3
- Bildgenerierung und automatische Spracherkennung (ASR)
- LoRA- und QLoRA-Finetuning
- Für Modelle der 70B-Klasse
Größere Frontier-Modelle wie DeepSeek-R1/V3 (671B) können über mehrere MI350P-Karten skaliert werden.
Software-Stack
Die MI350P wird unterstützt durch ROCm™ 7, ein breites Ökosystem etablierter KI-Frameworks und Laufzeitumgebungen:
- vLLM
- SGLang
- llama.cpp
- PyTorch
- JAX
- Triton
- ONNX Runtime
- TensorFlow
Vorkonfigurierte Container stehen über den AMD Infinity Hub sowie den AMD Enterprise AI Reference Stack zur Verfügung. Über HIP lassen sich bestehende CUDA-basierte Workflows in der Regel portieren.
Jetzt selbst testen
Die Evaluierung eigener Modelle und Anwendungen im MEGWARE Benchmark Center ist im Rahmen einer Erstanalyse kostenfrei möglich. Unsere HPC- und KI-Experten unterstützen Sie bei Einrichtung, Optimierung und Auswertung der Benchmarks und beraten Sie bei der Auswahl der optimalen Konfiguration für den produktiven Einsatz.
Weitere Informationen zur AMD InstinctTM MI350P